先让经验找得到
关联配方版本、原料牌号、实际投料、工艺和结果,保留为什么改、为什么没有采用。
现在的价值:少翻档案,复用已有经验
机器学习辅助配方研发 · 本厂经验持续积累
INCILABS 将机器学习用于化妆品配方研发:选择多个竞品、提取成分并校验数据,结合本地积累的配方习惯提供 F0 初始配方。每次打样与改动,都继续沉淀为下一轮的依据。
先整理与复用经验,再按品类建模,用实验验证效果。
机器学习研发常见问题 研发场景示意
从经验积累,到配方迭代
把配方、原料、工艺和实验结果连起来,保留每次调整的原因。先让已有经验可以查找和复用,再让经过验证的机器学习,帮助缩小下一轮打样范围。
关联配方版本、原料牌号、实际投料、工艺和结果,保留为什么改、为什么没有采用。
围绕同一品类与体系,选择用量参考或某项实测表现建模,用未参与训练的案例验证。
把经验证的参考用于候选筛选。新一轮打样继续记录改动和结果,经审核后补充经验。
企业本地运行 · 研发数据保护
真实配方、原料组成、投料比例与实验记录留在企业本地。模型的训练和推断都在本地完成,研发经验由企业自己管理。
大模型整理公开资料;企业私有配方与实验数据不发送给外部模型。
01 / 为什么用大模型
同一句评价,可能既认可“刚涂很好推开”,又抱怨“两小时后仍黏腻”。大模型结合上下文拆出体验、条件和原句,把分散的说法整理成研发能讨论的问题。
“刚涂很好推开;两小时后仍黏腻,叠加防晒时容易搓泥。”
整理后的观点需核对;评论中的体验感受与实验实测分别保存。
“想做一款保湿面霜,希望保湿表现好,用后也不黏腻。先围绕这两项目标比较试样。”
先把需求说清楚,再由配方师确认测试方法与接受条件。
“适用于乳化体系。建议添加量需结合具体应用体系核对,使用前应验证与其他原料的相容性。”
正式使用时关联原文、来源和资料版本,缺失信息保留为待确认。
点击切换示例 · 通用虚构示例,非客户资料或实时模型结果

02 / 本地机器学习 · 配方经验沉淀
配方是企业的核心资产。模型训练与推断都在企业本地完成,让本厂经验参与下一次研发判断。
03 / 系统怎样从竞品走到 F0
选多个竞品、提取成分,与大数据校验并学习搭配规律。再由本地机器学习结合历史配方习惯,提供更贴近本厂的 F0 初始配方。
本厂配方习惯在本地学习 · 私有配方与实验数据不外发
点击此步骤,继续查看系统如何从多个竞品形成 F0 初始配方;也可用左右方向键切换。
选择同类面霜作为目标组,按定位与体验确定本轮参考方向。
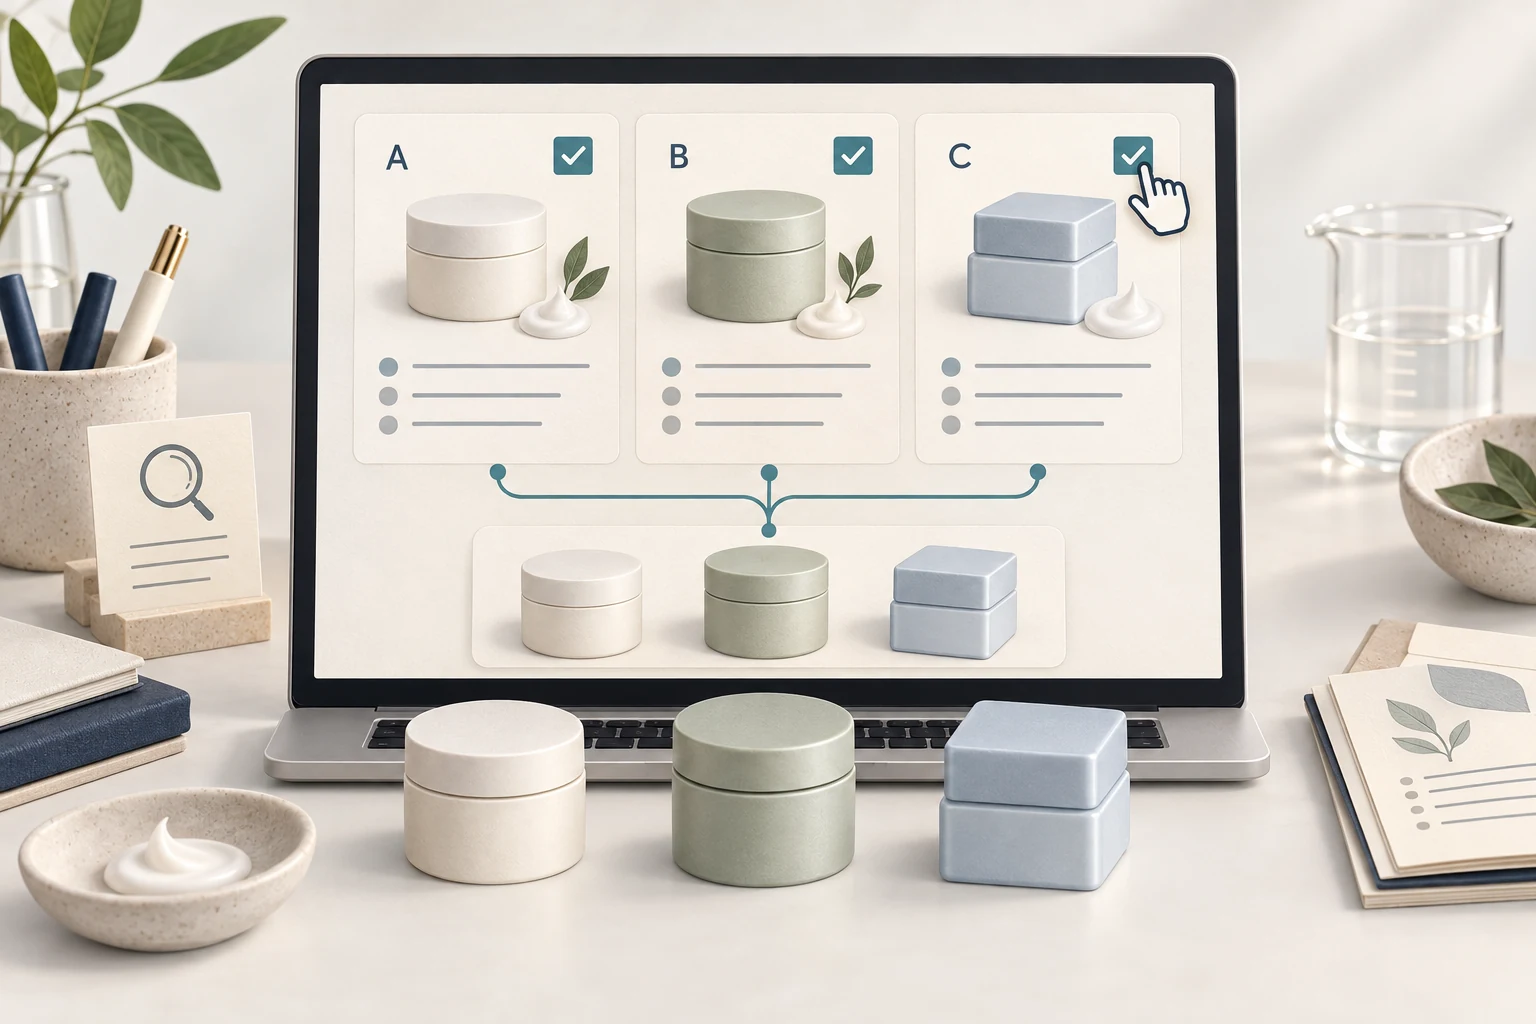
从已选产品获取公开成分信息,大模型辅助整理名称、顺序与来源。
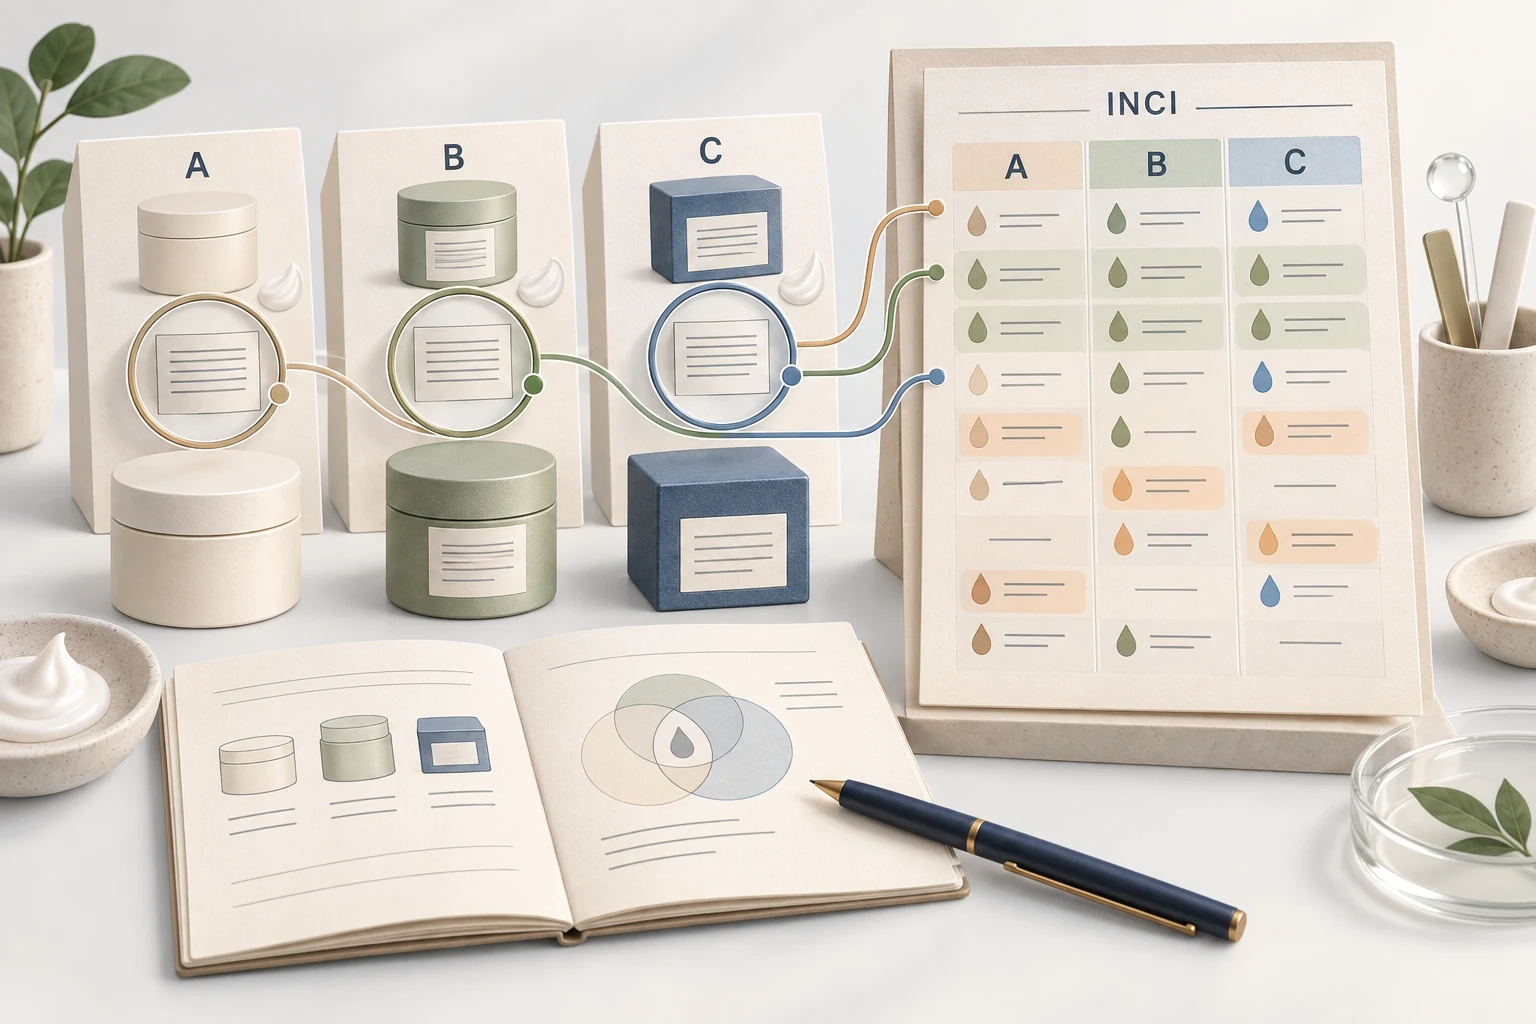
交叉核对成分与原料资料,归纳同类产品的组合规律和用量参考。
成分名称与顺序、适用限量、VCRP 历史使用信息及其他用量调查、公开备案资料、原料中各 INCI 的含量及原料建议添加量,共同作为参考;保留资料来源与待核对项。VCRP 是其中一个参考来源。
学习历史配方的常用原料、搭配与用量习惯。训练与推断都在企业本地完成。
融合竞品校验结果与本厂配方习惯,提供原料清单、建议百分比和依据。
F0:供配方师审核、打样的初始方案
点击任一步骤查看 · 通用功能场景示意,非真实界面或客户数据;F0 的建议百分比仍需实验验证。
04 / 机器学习辅助配方研发 FAQ
从数据、安全到 F0 打样,了解怎样把已有配方经验变成下一轮研发的依据。
INCILABS 产品说明 · 更新于
机器学习辅助配方研发,是从企业历史配方、实际投料、原料组成、工艺与实验结果中学习规律,辅助选料、用量估计和配方迭代。INCILABS 将它与多竞品对标结合,提供供配方师审核与打样的 F0 初始配方。
不会。INCILABS 机器学习的训练与推断都在企业本地完成,私有配方、原料组成、投料比例和实验数据不向外部模型或服务发送。本地经验按企业权限管理,后续打样与调整继续回写本地。
先选择多个同类竞品,提取公开成分,与 INCILABS 成分、原料和公开备案等数据交叉校验;再结合本地机器学习积累的选料、搭配与用量习惯,提供原料清单、建议百分比和参考依据。F0 经配方师审核与打样后,再回写改动和结果。
AI 灵感侧重理解需求、整理资料和展开候选思路;机器学习侧重从本厂真实配方与实验中学习选料、用量和工艺经验。AI 灵感的大模型部署与资料使用范围按企业配置确定;本地机器学习的私有研发数据不外发。两者都由配方师审核并安排验证。
可以从 Excel 配方和实验记录开始。优先关联配方版本、原料牌号、INCI 组成、实际投料百分比、工艺条件和对应实测结果。成功与未采用的方案都保留调整原因;缺失字段明确标记,逐步积累可比较的研发案例。
可以先从一个常做品类整理记录、检索相似配方和复用历史经验。能否启用预测,取决于具体任务、独立案例数量、数据质量和验证结果;相似版本不能简单当成很多独立样本。先验证一个具体问题,再逐步扩展。
不需要。企业可以针对用量参考、候选排序或某项实测表现建立专用模型,无需从零预训练通用大模型。本地部署说明训练与推断的位置,模型能做什么仍需通过本厂数据验证。
成分排序、适用法规限值、VCRP 历史使用信息及其他用量调查、同类历史配方、原料中各 INCI 的含量和建议添加量,共同帮助约束候选范围。不同资料保留来源与适用条件;VCRP 是参考之一,公开成分表不能直接还原竞品真实配比。
不能直接作为投产结论。F0 是配方师审核与打样的起点,建议百分比需要经过实际打样、性能与稳定性测试、法规核对,再按企业流程确认。改动和实测结果继续用于下一轮本地学习。
在同一品类与任务下,与原有人工流程比较资料检索时间、候选审核时间、达到目标的打样轮次及验证通过情况。用未参与训练的新案例检查效果,并记录适用范围;具体提速幅度以企业实际验证结果为准。
从已有配方与实验开始,先留住经验,再逐步建立经过验证的本地研发能力。